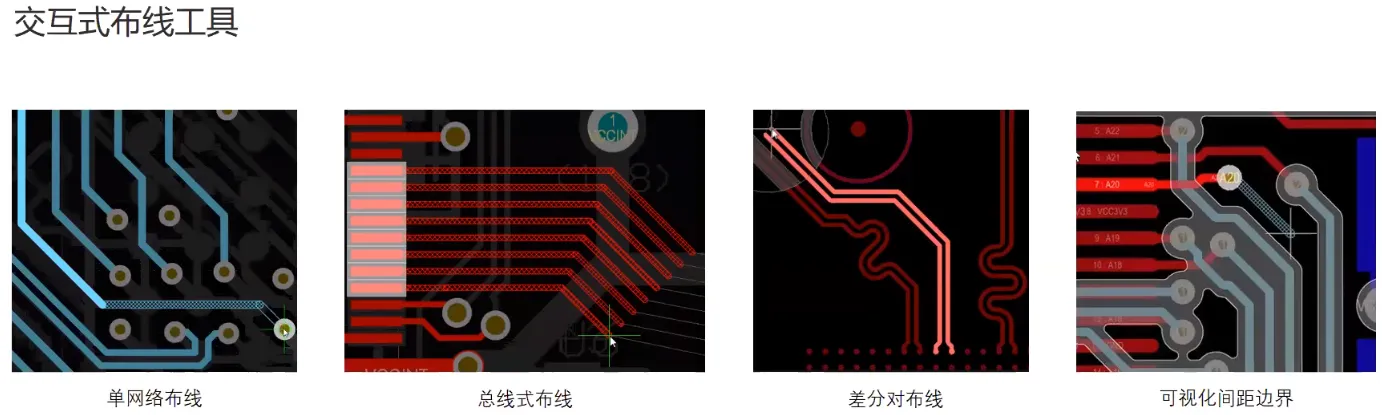
一、ALtium现有的布线技术
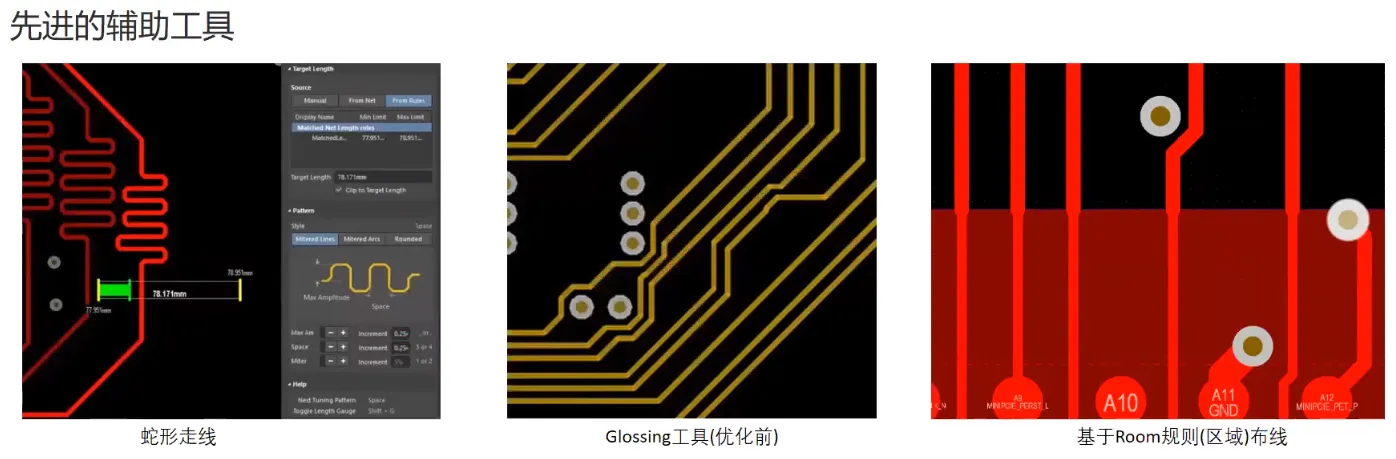
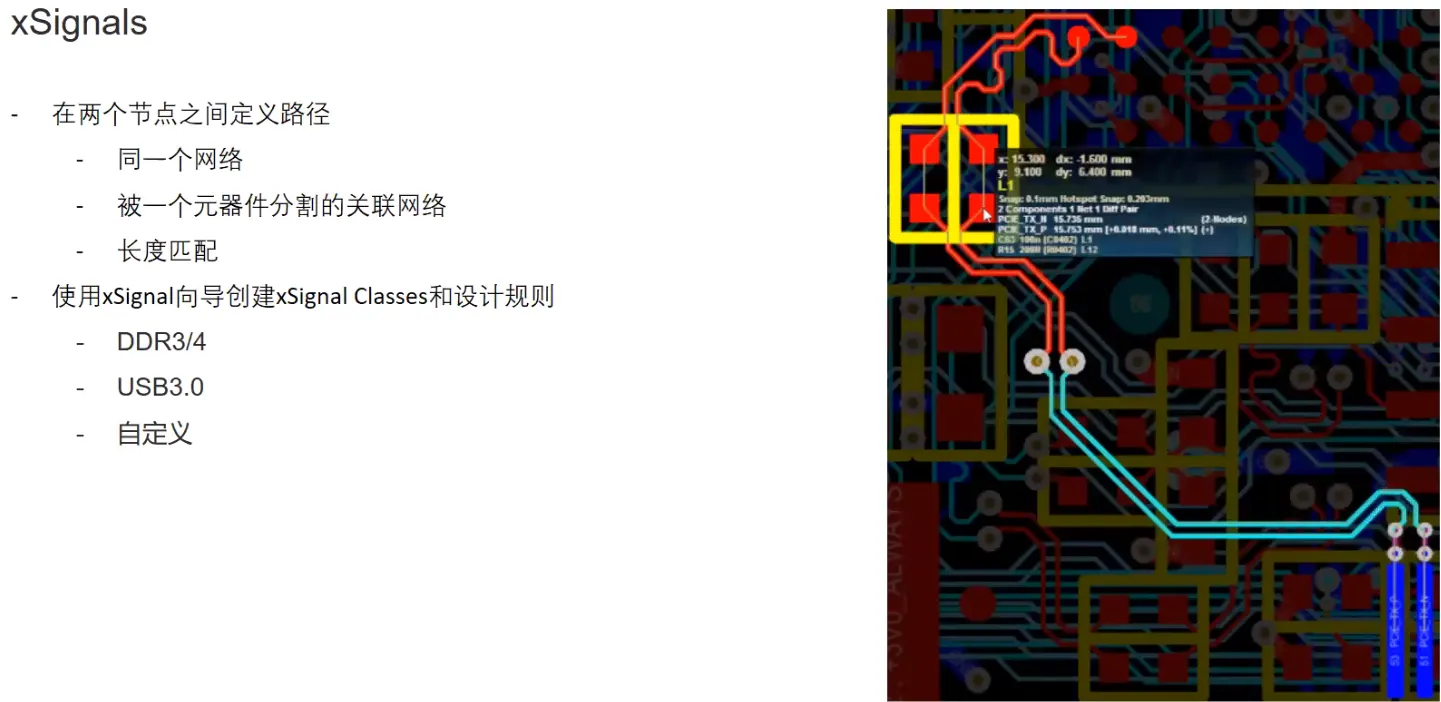
二、ActiveRoute基础
- 自动的交互式布线技术
- 适用于多引脚的 BGA 器件
- 优化逃逸布线
- 高质量的 River Routing 结果
- 定义 Guide 控制“流向”
- 使用已定义的设计规则
- 差分对布线
- 自动管脚交换
- 等长匹配
一、GDDR代表什么?
GDDR是图形双倍数据速率(Graphics Double Data Rate)的缩写,专为图形处理单元(GPU)设计的专用内存,旨在为现代图形渲染和计算所需的高数据传输需求提供高带宽支持。与用于通用系统任务和CPU的标准DDR(双倍数据速率)内存不同,GDDR针对游戏、3D 渲染和人工智能工作负载等需要并行处理和快速数据吞吐量的任务进行了优化。如今,GDDR已发展成为一种先进的内存解决方案,最新的GDDR7规范可提供每引脚高达48Gbps的速度和每个设备192GB/s的带宽。除游戏外,GDDR还成为AI加速器和需要高内存带宽的GPU的解决方案,以处理AI推理等高要求的工作负载。最新一代的GPU和AI系统现在依靠GDDR7来满足这些高级应用的性能需求。
二、 GDDR1–GDDR7 全代际对比
| 代际 | 量产年 | 每引脚速率 (Gbps) | 单颗带宽 (32bit) | 核心/IO 电压 | 信令技术 | 单芯片通道结构 |
|---|---|---|---|---|---|---|
| GDDR1 | 2001 | 1.6–2.0 | ~6.4–8 GB/s | 3.3 V | NRZ(SSTL) | 1×32bit(无多通道概念) |
| GDDR2 | 2003 | 2.0–4.0 | ~8–16 GB/s | 2.5 V | NRZ | 1×32bit |
| GDDR3 | 2004 | 1.0–4.0(后期) | ~4–16 GB/s | 1.8 V | NRZ | 1×32bit |
| GDDR4 | 2006 | 3.6–4.0 | ~14.4–16 GB/s | 1.8 V | NRZ(8n prefetch) | 1×32bit |
| GDDR5 | 2008 | 4.0–8.0 | 16–32 GB/s | 1.5 V(后期 1.35V) | NRZ(QDR, 8n) | 1×32bit(逻辑双通道 DQ 复用) |
| GDDR5X | 2016 | 10–14 | 40–56 GB/s | 1.35 V | NRZ(16n prefetch, QDR) | 1×32bit |
| GDDR6 | 2018 | 14–16(上限 24) | 56–64(上限 96)GB/s | 1.35 V(可 1.25V) | NRZ(QDR, 16n) | 2×16bit 独立通道 |
| GDDR6X | 2020 | 19–24 | 76–96 GB/s | 1.35 V | PAM4(非 JEDEC 标准,NVIDIA+Micron) | 2×16bit(同 GDDR6 物理) |
| GDDR7 | 2024(JEDEC JESD239) | 32(路线 48) | 128(上限 192)GB/s | 1.2 V(核心可低至 1.1V) | PAM3(3 电平,1.5 bit/symbol) | 4×8bit 独立通道 |
年经手过一个DDR4的设计返修。板子用的是4片DDR4颗粒,布线时直接套了DDR3的老方案,走了T型分支拓扑。分支出线长度控制得很仔细,每根都做到了50mil以内。单板调试一切正常。
但一上量就不行了。30%的板子在热机状态(65°C以上)出现偶发性的比特错误,示波器抓到的眼图惨不忍睹——眼高只勉强摸到0.55VDDQ,按JEDEC标准至少要0.7 VDDQ。折腾了两周,最后发现根因就是T型分支在高频下产生的信号反射,把时钟抖动从设计预算的12ps直接干到了60ps以上。
这个案例说明:DDR4时代,T型分支已经跑不动了。Fly-by拓扑才是正确的选择!
T型分支为什么不行?
T型拓扑的结构像一棵树:信号从控制器出来,在分支节点一分为二(或一分为四),同时送到各个DDR颗粒。DDR2时代这么用没问题,因为频率低、周期宽。但到了DDR4,时钟周期只有0.625ns。在这个时间尺度上,分支节点就是一个灾难。
问题一:分支节点产生阻抗突变
信号从一根50Ω单端线进入分支节点时,遇到的是并联的两根线。分支节点处的等效阻抗从50Ω骤降到25Ω左右。根据反射系数公式:
ZL是负载阻抗,Z0是源阻抗。当ZL=25Ω、Z0=50Ω时,Γ=-(25/75)≈-0.33。也就是说33%的信号能量被反射回源端。还有就是——反射波到达控制器后再弹回来,在走线里来回震荡,形成码间干扰(ISI)。实测数据显示,DDR4T型分支引入的额外抖动(Tj)超过1.8UI,足以让眼图直接闭合。
问题二:分支长度差异导致时序偏移
电信号在FR-4板材上的传播速度大约是光速的60%,即18cm/ns。
两条分支线差10mm,信号到达时间就差55ps——这在DDR2的2.5ns周期里只占2%不算什么,但在DDR4-3200的0.625ns周期里就是接近9%的偏移。控制器采样的窗口总共也就0.3UI左右,光这一项就把裕量吃掉一大块。
超过2000MHz之后,分支节点产生的反射波会和原始信号叠加,造成波形畸变。这个问题在设计阶段不好排查——因为信号完整性问题很多时候只在特定温度和电压组合下才暴露,就像我开头那个案例一样。
一、简介
PCI-E(Peripheral Component Interconnect Express)是一种高速串行计算机扩展总线标准,由英特尔在2001年提出,旨在替代旧的PCI、PCI-X和AGP总线标准。它广泛应用于显卡、固态硬盘、网卡等设备的连接,提供了高带宽和低延迟的性能。PCIE属于高速串行点对点双通道高带宽传输,所连接的设备分配独享通道带宽,不共享资源,主要支持主动电源管理,错误报告,端对端的可靠性传输,热插拔以及服务质量(QOS)等功能。
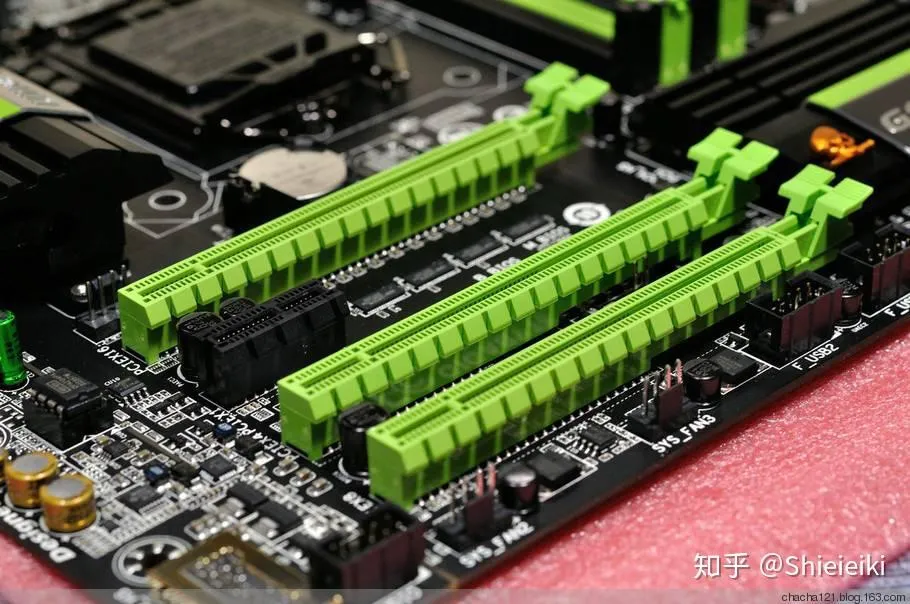
插槽模式
PCI-E接口有多种插槽模式,包括x1、x4、x8和x16,主要区别在于通道数量和带宽。例如:
-
PCI-E x16:提供16条通道,带宽最高,常用于显卡和高性能设备。
-
PCI-E x4:通常用于固态硬盘(如M.2 SSD)或扩展卡。
-
PCI-E x1:带宽较低,适合独立网卡、声卡等设备。
版本与性能
PCI-E标准不断升级,目前已发展到6.0版本。不同版本的带宽性能显著提升,例如:
-
PCI-E 3.0:每通道带宽约为8Gbps。
-
PCI-E 4.0:每通道带宽提升至16Gbps。
-
PCI-E 5.0:进一步提升至32Gbps。
应用场景
PCI-E接口广泛应用于以下场景:
-
显卡:通过x16插槽提供高带宽支持。
-
固态硬盘:M.2接口通常基于PCI-E通道,支持NVMe协议,传输速度远超SATA。
-
扩展卡:如网卡、声卡、USB扩展卡等,通常使用x1或x4插槽。
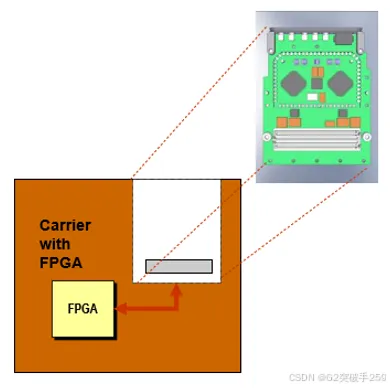
阐述了 FPGA Mezzanine Card (FMC) 标准的背景、优势及外形尺寸规范。详细介绍了单宽度和双宽度模块设计,以及 LPC 和 HPC 两种连接器的引脚分配与信号功能。同时对比了 FMC 与 FMC+ 标准的差异,并列举了 Intel 和 AMD Xilinx 主流开发板的 FMC 接口应用实例,提供了相关技术文档参考。
FMC 简介
FPGA 对 I/O 需求的变化适应性很强。在重新配置 FPGA 以实现新协议之后,只需更换物理 I/O 组件和连接器即可。除非 I/O 组件在扩展卡模块,否则需要改变板级设计。为了避免与设计变更相关的成本和工作量,设计人员一直依赖于 PCI Mezzanine Card (PMC) 和 Switched Mezzanine Card (XMC) 标准。然而,这些标准是多年前为单板计算机(SBCs)等通用解决方案开发的,而不是 FPGA。2008 年 7 月,随着美国国家标准协会(ANSI)批准和发布 VITA 57 FPGA Mezzanine Card (FMC) 标准,这种情况发生了变化。
下图为普通板级设计和基于 FMC 扩展卡的设计的区别:
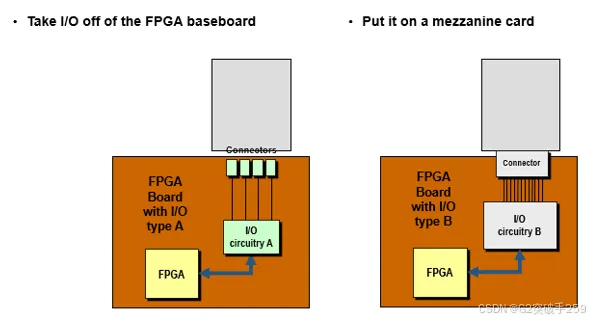
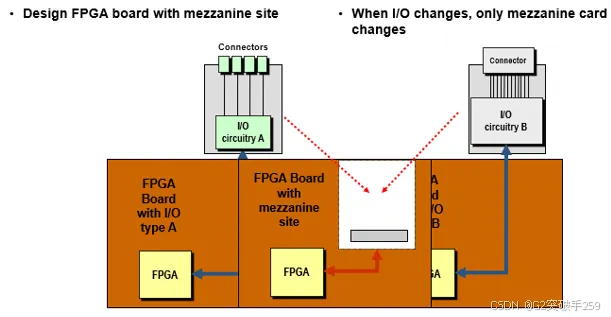
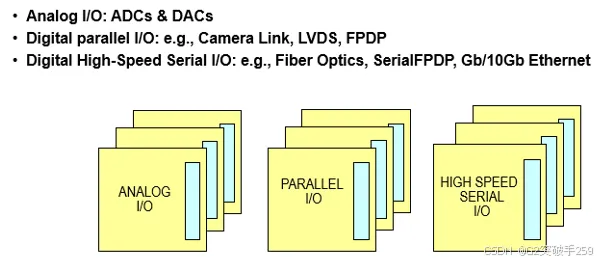
FMC 标准由从 FPGA 供应商到最终用户的公司联盟开发,旨在为位于基板(载卡)上的 FPGA 提供标准的扩展卡外形、连接器和模块化接口。以这种方式将 I/O 接口与 FPGA 解耦,简化了 I/O 接口模块设计,同时最大限度地提高了载卡的可重复使用能力。与使用 PCI、PCI-X、PCle 或 Serial RapidIO 等复杂接口的 PMC 和 XMC 标准不同,FMC 标准只需要直接连接到载卡上的 FPGA 的核心 I/O 和收发器电路。复杂接口标准在 FMC 扩展卡上实现。如下图所示,FMC 扩展卡可以支持以下接口标准:
- 模拟 I/O:ADC 和 DAC
- 数字并行 I/O:例如,Camera Link,LVDS,FPDP
- 数字高速串行 I/O:例如,光纤,串行 FPDP,Gb/10Gb 以太网